


¡Hola developer 👋🏻!
Estos días de vacaciones de Navidad, aunque prometí que iba a desconectar, hay algo que siempre me acompaña en mis ratos de café: leer y aprender cosas que no siento como una obligación.
Desde hace años uso este blog como mis propias notas de aprendizaje. Escribo para ordenar ideas, para poder volver a ellas en el futuro y encontrarlas de una forma que tenga sentido dentro de mi cabeza. Y ya que lo hago, lo comparto… por si a ti también te sirve o te ayuda en algún momento.
Así que, en uno de esos ratos tranquilos, justo en estos últimos días del año, me puse a jugar con FastAPI. Leí su documentación, probé ideas y monté una pequeña API para entender bien qué ofrece este framework del que tanto se habla.
De ahí sale este artículo: un resumen práctico de lo que he aprendido, pensado para que, si tienes poco tiempo, puedas hacerte una buena idea de por qué FastAPI merece la pena y cómo empezar con buen pie.
🚀 Setup minimalista (muy minimalista)
Antes de entrar en el código, hay un detalle que ya dice mucho de FastAPI:
lo poco que necesitas para empezar.
Mi requirements.txt contiene únicamente esto:
fastapi[standard]==0.128.0Y ya está 🤯
Ese extra standard incluye todo lo necesario para:
- Levantar un servidor ASGI (Uvicorn)
- Tener hot reload en desarrollo
- Y, lo que me parece súper brutal: documentación interactiva desde el primer minuto
En resumen: en pocos segundos tienes una API funcionando… y perfectamente documentada 🚀
🗂️ Estructura del proyecto y app.py
Para que el ejemplo sea un poco más realista, he modularizado el código y separado responsabilidades en distintos archivos. De esta forma, la aplicación es más fácil de mantener y se parece mucho más a cómo organizaríamos una API real.
.
├── app.py
├── requirements.txt
├── data
│   └── tracks.py
└── models
    ├── filterparams.py
    ├── track.py
    └── trackinfo.py
En el archivo principal (app.py) me quedo únicamente con los imports necesarios para definir la aplicación y los endpoints.
📄 app.py — punto de entrada de la aplicación
Empezamos por app.py, que es el punto de entrada de la aplicación. Aquí se inicializa FastAPI y se definen los endpoints de la API.
Para este ejemplo, siguiendo otros en los que he estado trabajando a finales de este año, he montado una API que gestiona las canciones de las cintas Awesome Mix de la saga de Guardianes de la Galaxia.
La excusa perfecta para que el ejemplo sea un poco más entretenido 🚀📼
Los imports
# FastAPI and typing imports
from fastapi import FastAPI, Query, Path
from typing import Annotated
# Local data and models defined within the project
from data.tracks import tracks
from models.filterparams import FilterParams
from models.track import Track
Aquí se ve bastante bien la filosofía de FastAPI:
- FastAPI se encarga de la definición de la aplicación y los endpoints
- Los modelos de dominio viven en su propio módulo
- Los datos (en este caso de ejemplo) están separados de la lógica de la API
Este enfoque tiene varias ventajas:
- El archivo principal queda limpio y fácil de leer
- Los modelos pueden reutilizarse en otros endpoints o servicios
- La estructura del proyecto escala mejor a medida que la API crece
Además, seguimos aprovechando los type hints en todo momento. FastAPI utiliza esta información no solo para ayudarte desde el editor, sino también para:
- Validar automáticamente los datos
- Generar la documentación OpenAPI
- Definir de forma clara el contrato de cada endpoint
A partir de aquí, app.py se centra únicamente en inicializar la aplicación y definir los endpoints, mientras que el resto del código vive donde tiene sentido.
Inicializando la aplicación
Una vez tenemos los imports, inicializamos la app:
app = FastAPI(title="Awesome Mix Cassette: Guardians of the Galaxy 🚀📼")Con esta única línea ya tenemos:
- Una aplicación ASGI
- Documentación automática
- Especificación OpenAPI generada
Definiendo los endpoints
A partir de aquí empezamos a definir los endpoints de la API:
@app.get("/")
async def root():
    """Expone información básica del servicio y enlaces a recursos útiles."""
    return {
        "service": "Awesome Mix API",
        "version": "1.0.0",
        "docs": {"swagger": "/docs", "redoc": "/redoc"},
        "resources": {"tracks": "/api/tracks"},
        "status": "ok",
    }
Y seguimos con un CRUD bastante clásico:
@app.get("/")
async def root():
    """Expose basic service metadata and helpful resource links."""
    return {
        "service": "Awesome Mix API",
        "version": "1.0.0",
        "docs": {"swagger": "/docs", "redoc": "/redoc"},
        "resources": {"tracks": "/api/tracks"},
        "status": "ok",
    }

@app.get("/api/tracks")
async def get_tracks():
    """Return the entire catalog of available tracks."""
    return tracks

@app.get("/api/tracks/{track_id}")
async def get_track(
    track_id: Annotated[int, Path(title="The ID of the track to get", ge=1)],
):
    """Look up a track by its identifier and respond with an error when missing."""
    for track in tracks:
        if track.id == track_id:
            return track
    return {"error": "Track not found"}

@app.post("/api/tracks")
async def create_track(track: Track):
    """Insert a new track into memory and return the confirmed object."""
    tracks.append(track)
    return track

@app.put("/api/tracks/{track_id}")
async def update_track(
    track_id: Annotated[int, Path(title="The ID of the track to update", ge=1)],
    updated_track: Track,
):
    """Replace the existing track with the provided data when a match is found."""
    for index, track in enumerate(tracks):
        if track.id == track_id:
            tracks[index] = updated_track
            return updated_track
    return {"error": "Track not found"}

@app.delete("/api/tracks/{track_id}")
async def delete_track(track_id: int):
    """Remove a track from the catalog when the id matches."""
    for track in tracks:
        if track.id == track_id:
            tracks.remove(track)
            return {"message": "Track deleted"}
    return {"error": "Track not found"}
Cada endpoint recibe exactamente lo que necesita:
- Body validado automáticamente gracias a Pydantic
- Path params tipados y validados
- Errores claros cuando algo no cumple el contrato
El framework se encarga del “trabajo pesado” y tú te centras en la lógica.
📁 data/tracks.py — datos de ejemplo
Para poder probar la API fácilmente, he añadido un array en memoria con algunas canciones:
tracks: list[Track] = [
    Track(
        id=1,
        title="Hooked on a Feeling",
        artist="Blue Swede",
        info=TrackInfo(
            album="Awesome Mix Vol. 1",
            year=1974,
            duration_seconds=176,
            spotify_url="https://open.spotify.com/track/5jrdCoLpJSvHHorevXBATy",
        ),
        featured_in=["Guardians of the Galaxy (2014)"],
        rating=5,
    ),
    ...
]
Aquí ya se ve otra ventaja clara:
los datos que usas cumplen exactamente el contrato definido por tus modelos.
📁 models/trackinfo.py y models/track.py — modelos de dominio
En la carpeta models/ se definen los modelos de dominio usando Pydantic:
📄 models/trackinfo.py
from pydantic import BaseModel, Field, HttpUrl

class TrackInfo(BaseModel):
    """Provide discography details and auxiliary links for a track."""
    album: str = Field(
        ..., examples=["Awesome Mix Vol. 1"], description="Name of the original album."
    )
    year: int = Field(
        ...,
        ge=1960,
        le=2030,
        examples=[1974],
        description="Official release year of the track.",
    )
    duration_seconds: int | None = Field(
        default=None,
        gt=0,
        examples=[178],
        description="Approximate duration expressed in seconds.",
    )
    spotify_url: HttpUrl | None = Field(
        default=None,
        examples=["https://open.spotify.com/track/0y4lG7uMBf9H3lmNwJXilO"],
        description="Optional Spotify link to play the track.",
    )
📄 models/track.py
from pydantic import BaseModel, Field
from models.trackinfo import TrackInfo

class Track(BaseModel):
    """Describe each song, its origin, and catalog metadata."""
    id: int
    title: str = Field(
        ..., examples=["Hooked on a Feeling"], description="Official track title."
    )
    artist: str = Field(
        ..., examples=["Blue Swede"], description="Primary performer of the song."
    )
    info: TrackInfo
    featured_in: list[str] = Field(
        default_factory=list,
        examples=[["Guardians of the Galaxy (2014)"]],
        description="List of movies where the track appears.",
    )
    rating: int | None = Field(
        default=None,
        ge=1,
        le=5,
        description="Subjective rating on a 1-to-5 star scale.",
    )
Lo interesante aquí es que:
- Definimos estructura + validación en el mismo sitio
- Los modelos se validan automáticamente al usarse
- Los ejemplos y restricciones aparecen directamente en Swagger
- Los errores son claros y consistentes
Con muy pocas líneas tienes:
- Clases
- Validaciones
- Documentación
- Contratos de la API
📁 models/filterparams.py — filtros de búsqueda
FastAPI permite ir un paso más allá y usar modelos también para los filtros de búsqueda:
@app.get("/api/search")
async def search_tracks(
    filter_query: Annotated[FilterParams, Query()],
    q: Annotated[
        str | None,
        Query(
            title="Search",
            description="Search query for Awesome Mix tracks",
            min_length=2,
            examples=["feeling"],
        ),
    ] = None,
):
    """Filter tracks by free-text search, movie appearances, and dynamic ordering."""
    items = tracks
    if q:
        needle = q.lower()
        # Narrow the list to partial matches in title, artist, or album name.
        items = [
            track
            for track in items
            if needle in track.title.lower()
            or needle in track.artist.lower()
            or needle in track.info.album.lower()
        ]
    if filter_query.featured_in:
        requested = {value.lower() for value in filter_query.featured_in}
        # Keep only the tracks that appear in any of the requested movies.
        items = [
            track
            for track in items
            if any(movie.lower() in requested for movie in track.featured_in)
        ]
    order_key = {
        "title": lambda track: track.title.lower(),
        "artist": lambda track: track.artist.lower(),
        "year": lambda track: track.info.year,
    }.get(filter_query.order_by, lambda track: track.title.lower())
    # Sort the in-memory collection according to the computed key.
    items = sorted(items, key=order_key)
    total = len(items)
    start = filter_query.offset
    end = start + filter_query.limit
    # Return a paginated payload along with query parameters to ease debugging.
    return {
        "total": total,
        "items": items[start:end],
        "query": q,
        "order_by": filter_query.order_by,
        "featured_in": filter_query.featured_in,
    }
Aquí estamos agrupando parámetros de query en un solo modelo:
from typing import Literal
from pydantic import BaseModel, Field

class FilterParams(BaseModel):
    """Manage pagination, ordering, and optional filters for catalog searches."""
    limit: int = Field(
        50,
        gt=0,
        le=100,
        description="Maximum number of results to return per page.",
    )
    offset: int = Field(
        0,
        ge=0,
        description="Starting position within the catalog for pagination.",
    )
    order_by: Literal["title", "artist", "year"] = Field(
        "title",
        description="Field used to order the results.",
    )
    featured_in: list[str] = Field(
        default_factory=list,
        description="Optional filter by movie titles where the track appears.",
    )
Gracias a esto:
- Definimos mínimos y máximos con
Field - Limitamos valores posibles con
Literal - Evitamos endpoints con mil parámetros
- Swagger muestra los filtros de forma clara y ordenada
Y lo más importante de todo…
👉 Todo esto se construye a partir de type hints.
Los type hints no son opcionales en FastAPI:
- Definen el contrato de la API
- Activan validaciones
- Generan documentación
- Hacen el código más legible y mantenible
FastAPI te empuja (en el buen sentido) a escribir mejor Python desde el primer momento.
Y esa, para mí, es una de sus mayores virtudes 💙
▶️ Cómo ejecutar la API en modo desarrollo
Una vez que tengas guardado todo lo anterior, lo único que necesitas hacer es ejecutar la aplicación con el CLI oficial de FastAPI, que estará disponible automáticamente al instalar el módulo anterior.
fastapi dev app.pyEste comando arranca el servidor en modo desarrollo, lo que implica varias cosas muy interesantes:
- 🔁 Recarga automática cada vez que haces cambios en el código
- 🚀 No necesitas configurar nada adicional
- 🧠 FastAPI detecta la app sin tener que indicarle imports ni nombres de variables
- 📄 La documentación se genera y actualiza automáticamente
Además, al levantar la aplicación tendrás disponibles tres endpoints clave:
- Tu API ejecutándose:
👉 http://localhost:8000 - Swagger UI (OpenAPI) para probar la API desde el navegador:
👉 http://localhost:8000/docs - ReDoc, una vista alternativa de la documentación:
👉 http://localhost:8000/redoc
En cuestión de segundos tienes una API funcionando, documentada y lista para probar.
📚 Documentación automática: Swagger UI y ReDoc
Una de las cosas que más me gustan de FastAPI es que la documentación no es un extra, sino parte central del framework.
Nada más arrancar la aplicación, FastAPI genera automáticamente dos interfaces de documentación distintas, basadas en la misma especificación OpenAPI.
Swagger UI (/docs)
La primera que probablemente ya conozcas es Swagger UI:
Swagger es una interfaz interactiva, pensada para:
- Explorar los endpoints disponibles
- Ver qué parámetros acepta cada uno
- Probar peticiones directamente desde el navegador
- Validar bodies y query params sin escribir código
Es ideal para desarrollo y testing rápido, tanto para ti como para otros miembros del equipo.
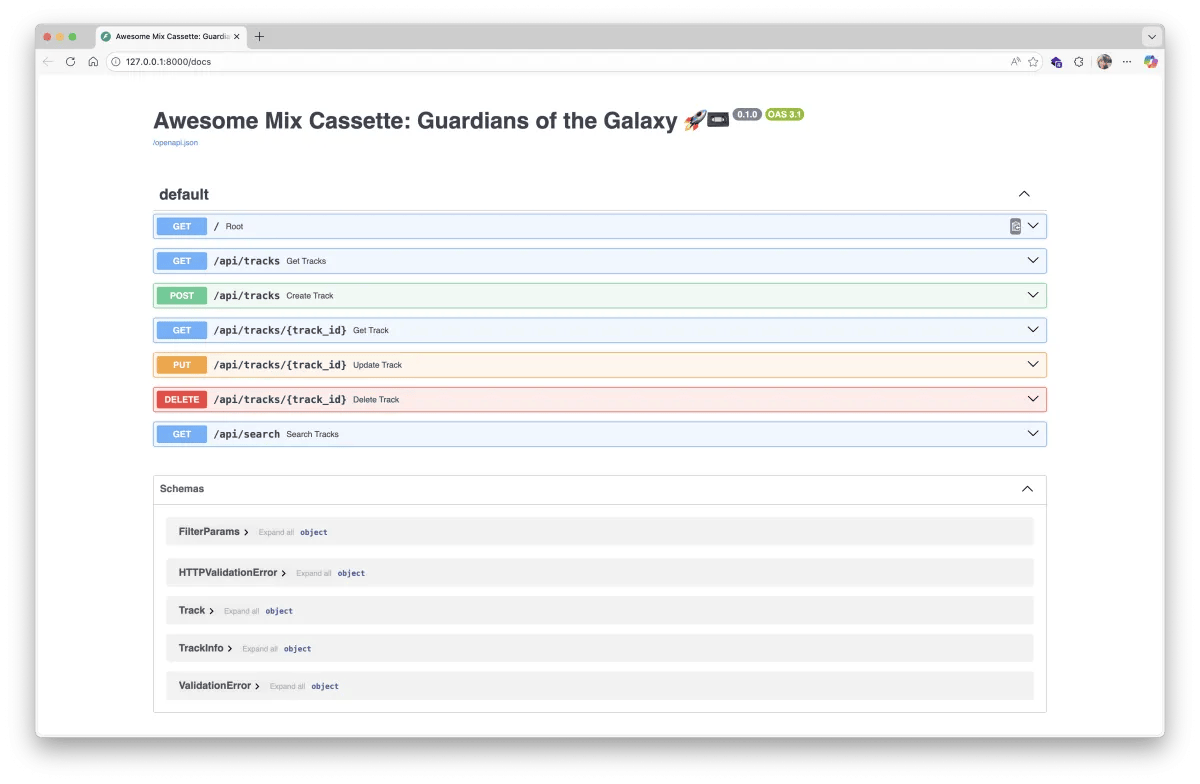
Y ya que estamos aquí, merece la pena pararse un momento a ver lo bien que quedan los esquemas en Swagger UI con todo lo que hemos definido hasta ahora:
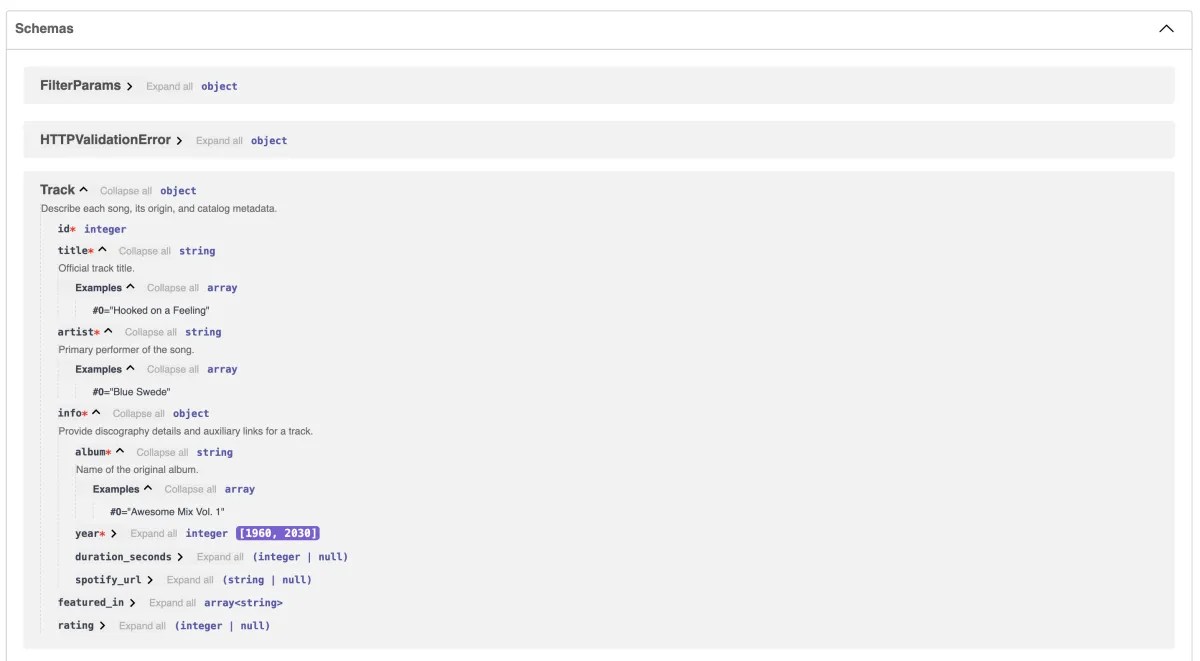
Gracias a los modelos con Pydantic, a los type hints, a los comentarios, a los ejemplos y a las validaciones, FastAPI es capaz de generar automáticamente un schema muy rico y fácil de entender. No solo ves los campos y sus tipos, sino también:
- qué campos son obligatorios
- los rangos válidos
- los valores opcionales
- ejemplos reales
- y la estructura completa de los modelos anidados
Todo esto sale directamente del código, sin escribir documentación adicional.
El resultado es una API que no solo funciona bien, sino que además se explica sola.
ReDoc (/redoc)
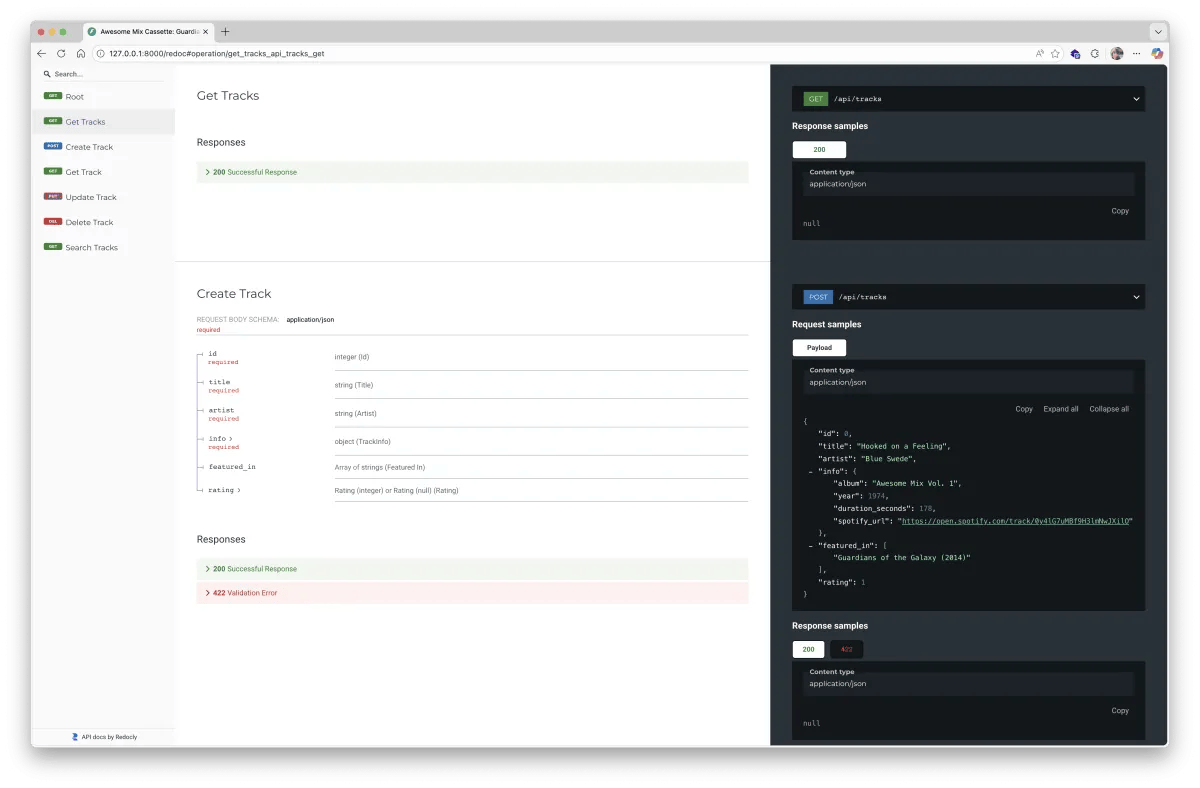
FastAPI también expone automáticamente ReDoc:
ReDoc ofrece una vista más limpia y orientada a lectura, muy pensada para:
- Documentación de APIs públicas
- Revisar contratos con calma
- Compartir la API con otros equipos
No está pensada tanto para ejecutar peticiones, sino para entender la API como un todo: modelos, esquemas, descripciones y relaciones entre recursos.
🧠 FastAPI se siente Python moderno desde el principio
Una de las sensaciones más claras al trabajar con FastAPI es que estás desarrollando “bien” desde el primer momento, sin forzar buenas prácticas ni añadir capas artificiales.
Algunas de las cosas que más me han gustado:
- Tipado estático con type hints
Los type hints no solo ayudan al IDE: permiten que FastAPI valide datos, genere documentación y detecte errores antes de ejecutar el código. El editor sabe exactamente qué espera cada endpoint. async/awaitsin complicaciones
No hay que pelearse con configuraciones extra. Si quieres trabajar de forma asíncrona, FastAPI está preparado desde el inicio.- Uniones de tipo (
int | None,str | None)
El código es expresivo, claro y fácil de leer, sin necesidad de estructuras complejas. Annotatedpara enriquecer parámetros
Permite añadir validaciones, descripciones y restricciones directamente sobre los tipos, manteniendo el código limpio y declarativo.- Validaciones declarativas gracias a Pydantic
Definir cómo son los datos y que se validen automáticamente se convierte en algo natural, no en una tarea extra.
🎯 ¿Para quién encaja especialmente FastAPI?
FastAPI encaja especialmente bien si vienes de Flask y echas de menos tipado y validaciones, o si vienes de otros frameworks más pesados y buscas algo moderno, rápido y muy Pythonic.
📝 Conclusión
FastAPI no solo es rápido en ejecución, también lo es en productividad.
Te empuja a escribir:
- código claro
- APIs bien definidas
- contratos explícitos
- documentación útil
Y todo ello con muy poco esfuerzo.
Si estás empezando una API en Python o quieres modernizar la forma en la que las construyes, FastAPI es, sin duda, un framework que merece la pena conocer a fondo.
ℹ️ Nota final
En este artículo no he entrado en otros temas igual de importantes como:
No porque FastAPI no los cubra (todo lo contrario), sino porque el objetivo aquí era no hacer el artículo más extenso de lo que ya es y centrarme en que pudieras ver, de forma sencilla y práctica, todo lo que te aporta este framework desde el primer momento.
La idea era mostrar cómo, con muy poco código, puedes tener:
- una API funcional
- bien tipada
- validada
- y documentada automáticamente
Además, te dejo este repositorio en mi cuenta de GitHub con el código completo de este ejemplo para que puedas clonarlo, ejecutarlo y ver el resultado por ti mismo.
Así podrás comprobar lo sencillo que es empezar a trabajar con FastAPI y jugar con el código sin miedo 🚀
¡Nos vemos 👋🏻!